# Chunk B6.02
# Mengaktifkan packages
library(Benchmarking)
library(frontier)6 Stochastic Frontier Analysis
Teknik analisis frontier yang lain ialah stochastic frontier analysis atau sering disingkat SFA. Teknik ini dianggap lebih rumit dibandingkan dengan DEA, tetapi memiliki landasan yang lebih masuk akal. Hal tersebut disebabkan oleh nilai produksi yang dihasilkan oleh suatu unit usaha dapat dipengaruhi oleh suatu kejadian acak yang berada di luar kendali unit tersebut.
Seperti yang sudah dibahas pada Bab II, SFA adalah suatu metode pengukuran efisiensi dengan pendekatan parametrik. Artinya, nilai output dari masing-masing rumah sakit dapat dijelaskan berdasarkan nilai input, faktor-faktor lain yang memengaruhinya, dan suatu nilai acak. Bab ini akan membahas aplikasi SFA menggunakan R.
6.1 Membuat Grafik SFA dengan Data Contoh
Sebelum masuk pada analisis data rumah sakit, kita akan mempelajari alur analisis SFA menggunakan data contoh sebagaimana yang dipakai oleh Bogetoft dan Otto (2010).
Tahap 1. Menginstal dan Mengaktifkan Packages yang Diperlukan
Tahap pertama yang perlu dilakukan, yaitu mengaktifkan packages “Benchmarking” dan “frontier” yang sudah diinstal sebelumnya dengan menjalankan skrip berikut.
Tahap 2. Membuka Data
Pada bagian ini, kita menggunakan data charnes1981, yaitu dataset contoh dari penelitian program bantuan pendidikan di Amerika Serikat (Bogetoft dan Otto, 2010; Charnes, Cooper, dan Rhodes, 1981). Data ini dipakai hanya untuk memperagakan bentuk garis OLS, COLS, dan SFA dengan satu input dan satu output. Untuk konteks kesehatan, bayangkan x1 sebagai indeks sumber daya awal fasilitas dan y1 sebagai indeks capaian layanan; pemetaan ini hanya analogi pengajaran dan tidak mengubah angka, asal data, atau hasil estimasi asli. Gunakan help(charnes1981) untuk keterangan lengkap dataset.
CatatanCatatan edisi daring
Edisi cetak menjelaskan konteks pendidikan asli. Edisi daring menambahkan analogi kesehatan agar pembaca dapat memahami bentuk grafik sebelum memakai data rumah sakit pada bagian berikutnya; angka dan model contoh tidak diubah.
# Chunk B6.03
# Membuka data charnes1981
data("charnes1981")
c81 <- as.data.frame(charnes1981)
Tahap 3. Menentukan Variabel Input (x) dan Output (y)
Pada tahap ini, kita akan mendefinisikan satu variabel input dan satu variabel output, yaitu x1 dan y1. Variabel y1 merupakan output yang berupa skor membaca, sedangkan variabel x1 merupakan input yang berupa tingkat pendidikan ibu. Perintah yang bisa dijalankan pada tahap ini, yaitu:
# Chunk B6.04
x <- c81$x1
y <- c81$y1
Tahap 4. Estimasi dengan OLS, COLS, dan SFA
Dari variabel input dan output yang sudah didefinisikan sebelumnya, kita akan mencoba melihat hubungan keduanya menggunakan beberapa pendekatan. Pertama, kita akan mengestimasi regresi linear sederhana atau Ordinary Least Square (OLS). Cara ini bertujuan untuk mendapatkan suatu garis lurus (linear) yang dapat memprediksi nilai output berdasarkan nilai input tertentu dengan meminimalkan jumlah kuadrat dari nilai output prediksi dan nilai sebenarnya.
Pendekatan yang kedua, yaitu Corrected Ordinary Least Square (COLS) yang pada intinya merupakan garis lurus dengan kemiringan sama (sejajar) dengan OLS, tetapi intersep (nilai y saat x = 0) dikoreksi sehingga garis tersebut menyentuh unit yang memiliki nilai y tertinggi. Ketiga, kita juga akan mengestimasi hubungan x dan y dengan metode Stochastic Frontier Analysis (SFA). Dalam hal ini, karena kita mengacu pada suatu fungsi produksi dengan satu output dan satu input maka variabel x dan y ditransformasi menjadi bentuk log.
Dapat diperhatikan pada kotak skrip di bawah ini bahwa bentuk umum dari estimasi OLS dalam bahasa R adalah “lm ( y ~ x)”. Untuk estimasi SFA, perintah yang kita gunakan berasal dari package “frontier” yang memiliki bentuk umum “sfa ( y ~ x)”.
# Chunk B6.05
# Estimasi dengan OLS
ols <- lm(log(y) ~ log(x))
# Estimasi nilai intersep untuk garis COLS
coef(ols)[1] + max(residuals(ols))
#> (Intercept)
#> 1.686146# Estimasi Stochastic Frontier Analysis
msfa <- sfa(log(y) ~ log(x))Tahap 5. Membuat Grafik
Setelah model OLS, COLS, dan SFA selesai diestimasi, kita akan mencoba melihat bagaimana tampilan garis efisiensi tersebut. Terdapat tiga gambar, yakni garis regresi linear (Gambar 6.1), gambar garis regresi linear dan garis regresi terkoreksi (Gambar 6.2), dan regresi linear, garis regresi terkoreksi, dan garis SFA (Gambar 6.3). Ketiga gambar tersebut dibuat menggunakan paket “ggplot2” dengan penjelasan sebagai berikut.
Pertama, objek bernama “plot_ols” (lihat Gambar 6.1) yang terdiri atas dua jenis diagram, yaitu diagram titik yang dibuat menggunakan fungsi “geom_point()” dan garis linear yang dibuat menggunakan fungsi “geom_ abline()”. Pada dasarnya, grafik yang dihasilkan berupa nilai kasar (raw) dari data yang ada digambarkan dengan diagram titik (scatter plot), kemudian di atasnya ditampilkan juga sebuah garis lurus yang menggambarkan hasil estimasi atau prediksi dari model OLS.
Seperti yang sudah dijelaskan pada bagian sebelumnya, parameter yang harus dimasukkan pada fungsi “geom_point()” adalah data dan variabel x dan y apa yang akan digunakan. Dalam hal ini, variabel x-nya adalah bentuk logaritma dari matriks “x” dan variabel y-nya adalah bentuk logaritma dari matriks “y”. Selanjutnya, pada fungsi “geom_abline()”, ada dua parameter yang perlu diisi, yaitu intercept dan slope. Dalam hal ini, perlu diingat lagi persamaan garis lurus, yaitu “y = a + bx”, di mana a adalah intercept (nilai y ketika x = 0), dan b adalah slope atau kemiringan garis lurus tersebut. Adapun nilai dari keduanya didapatkan dari hasil pemodelan OLS (menggunakan fungsi bawaan “coef()”) yang sudah dilakukan pada Tahap 4. Perhatikan bahwa daftar koefisien berupa matriks dua kolom dengan kolom pertama (“coef(ols)[1]”) menyimpan nilai intercept dan kolom kedua (“coef(ols) [2]”) menyimpan nilai slope.
# Chunk B6.06
# 1. Membuat garis OLS
plot_ols <- ggplot() +
  geom_point(mapping = aes(x=log(x), y=log(y))) +
  geom_abline(intercept=coef(ols)[1], slope=coef(ols)[2])
plot_ols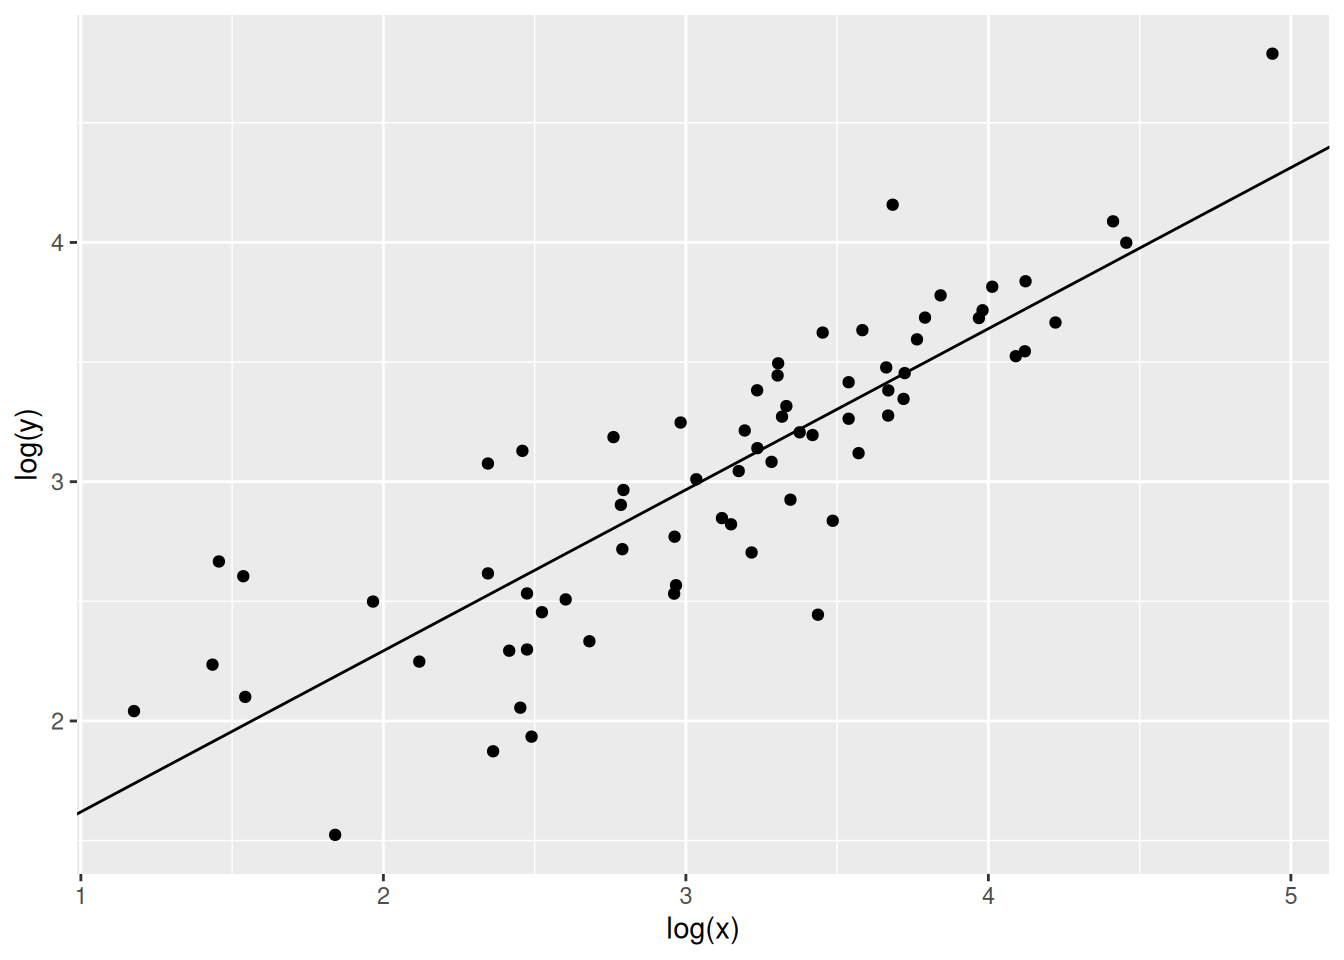
Kedua, garis COLS akan ditambahkan pada diagram yang sudah dibuat sebelumnya (objek “plot_ols”). Karena “ggplot” menggunakan pendekatan lapisan-lapisan grafis maka untuk menambahkan garis baru ini yang perlu dilakukan adalah menambah lapisan baru dengan fungsi “plot_ols + geom_abline()” lagi. Perlu diperhatikan bahwa intercept pada garis COLS merupakan intercept yang sama dengan garis OLS, namun ditambahkan dengan nilai tertinggi dari residual pada model OLS (“max(residuals(ols))”). Perintah berikut ini akan membuat sebuah objek dengan nama “plot_ols_ cols” dengan garis COLS berwarna merah (Gambar 6.2).
# Chunk B6.07
# 2. Menambahkan garis COLS
plot_ols_cols <- plot_ols +
  geom_abline(intercept=coef(ols)[1]+max(residuals(ols)),
  slope=coef(ols)[2], color="red")
plot_ols_cols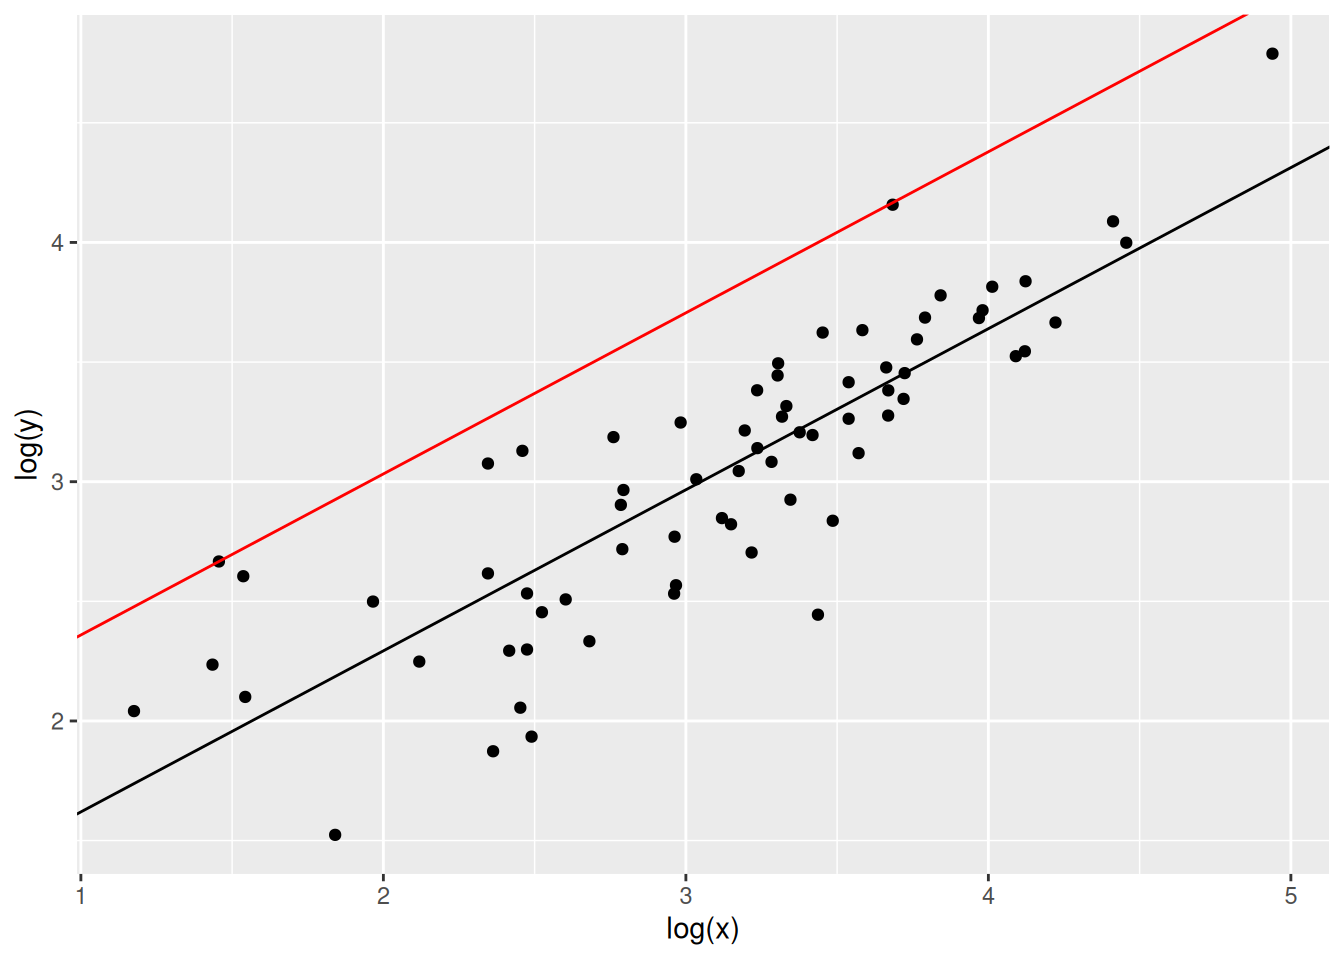
Ketiga, garis SFA akan ditambahkan pada diagram yang sudah dibuat sebelumnya (objek “plot_ols_cols”) dengan perintah “+ geom_abline()”. Sama seperti sebelumnya, parameter yang perlu diisi adalah intercept dan slope. Keduanya didapatkan dari objek “coef(msa)” yang merupakan matriks hasil estimasi SFA yang sudah dilakukan sebelumnya. Diagram yang dihasilkan pada langkah ini diberi nama “plot_ols_cols_sfa” (lihat Gambar 6.3).
# Chunk B6.08
# 3. Menambahkan garis SFA
plot_ols_cols_sfa <- plot_ols_cols +
  geom_abline(intercept=coef(msfa)[1], slope=coef(msfa)[2],
  color="blue")
plot_ols_cols_sfa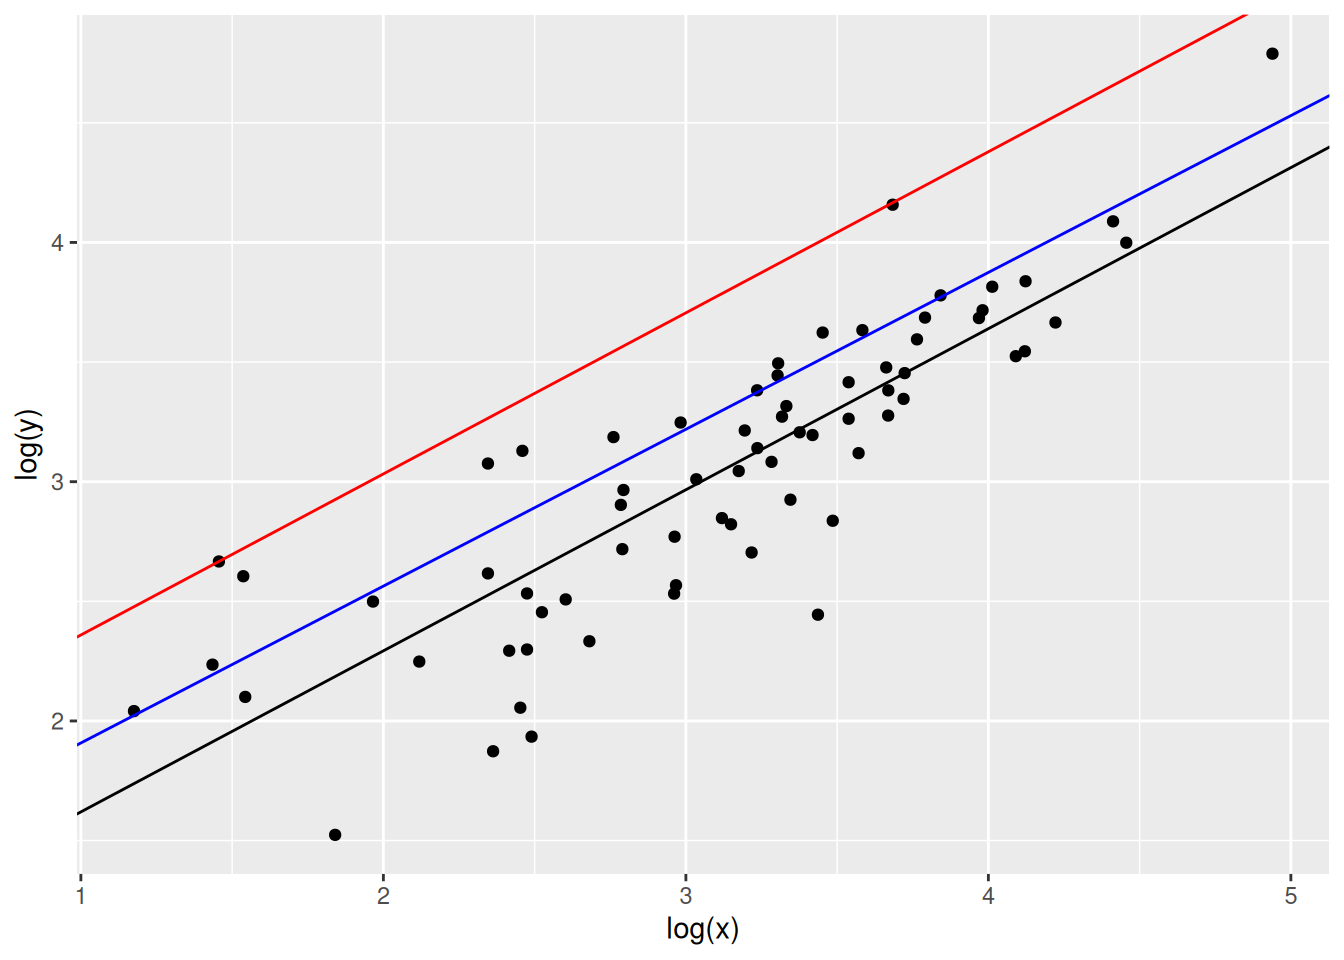
Pada Gambar 6.3 terlihat tiga garis, yaitu garis OLS (garis hitam tegas), garis COLS (garis hitam titik-titik), dan garis SFA (garis merah putus-putus). Unit yang berada di bawah garis tersebut dapat diinterpretasikan sebagai unit yang tidak efisien, sementara yang ada tepat atau di atas garis dianggap efisien sempurna. Dapat dilihat secara sekilas bahwa hanya ada dua unit yang efisien sempurna jika teknik COLS digunakan. Jumlah unit yang efisien menjadi lebih banyak jika menggunakan teknik OLS, tetapi lebih banyak lagi jika menggunakan garis SFA. Gambaran tersebut sesuai dengan teori yang menyatakan bahwa selisih antara garis prediksi (OLS) dengan nilai aktual dari suatu unit dapat disebabkan oleh suatu kejadian acak.
6.2 Menentukan Nilai Efisiensi
Setelah kita memahami bagaimana membuat garis SFA pada konteks produksi dengan satu output dan satu input, kita akan mempelajari bagaimana cara mengestimasi nilai efisiensi dengan teknik SFA. Dataset yang akan kita gunakan adalah data produksi susu di Denmark. Variabel yang ada pada dataset ini, yaitu: “farmNo” (nomor urut peternakan); “milk” (susu yang dihasilkan, kg); “energy” (tagihan energi); “vet” (tagihan dokter hewan); dan “cows” (jumlah sapi).
Tahap 1. Membuka Dataset dan memberi nama variabel kesehatan
Dataset milkProd pada paket frontier adalah data produksi susu Denmark yang dipakai untuk contoh SFA oleh Bogetoft dan Otto (2010). Agar pembaca dapat mengikuti alur secara dekat dengan fasilitas kesehatan, kolomnya diberi nama analitis: milk menjadi services (volume layanan), cows menjadi beds_proxy (proksi kapasitas), energy menjadi utilities_cost, dan vet menjadi clinical_support_cost. Nilainya tidak diubah; ini bukan data rumah sakit dan bukan klaim bahwa biaya hewan sama dengan biaya klinis.
CatatanCatatan edisi daring
Edisi cetak memakai nama variabel peternakan. Edisi daring hanya mengganti nama kerja dalam objek baru untuk membantu pembelajaran konteks kesehatan; data sumber, angka, dan spesifikasi SFA tetap sama.
# Chunk B6.09
# Memuat data sumber lalu membuat salinan dengan nama analitis kesehatan.
data("milkProd")
milkData <- as.data.frame(milkProd)  # Objek asli dipertahankan untuk contoh fungsi jarak berikutnya.
healthExample <- as.data.frame(milkProd) |>
  dplyr::transmute(
    facility_id = farmNo, services = milk, utilities_cost = energy,
    clinical_support_cost = vet, beds_proxy = cows
  )
# Tabel ini adalah keluaran pertama: ringkasan ukuran dan sebaran variabel contoh.
gtsummary::tbl_summary(healthExample) |> gtsummary::as_flex_table()
Characteristic | N = 1081 |
|---|---|
facility_id | 55 (28, 82) |
services | 747,572 (548,924, 964,332) |
utilities_cost | 110,722 (75,168, 141,522) |
clinical_support_cost | 50,758 (30,742, 71,213) |
beds_proxy | 100 (79, 126) |
1Median (Q1, Q3) | |
Hasil yang diharapkan: tabel ringkasan satu baris per variabel. Interpretasi: tabel membantu memeriksa apakah semua nilai positif sebelum mengambil logaritma; logaritma tidak dapat dihitung untuk nol atau angka negatif. ### Tahap 2. Menghitung Nilai Efisiensi
Untuk menghitung nilai efisiensi dengan lebih dari satu input, kita mendefinisikan fungsi produksi terlebih dahulu. Pada salinan analitis kesehatan, services dipengaruhi oleh clinical_support_cost, utilities_cost, dan beds_proxy. Ini adalah perubahan nama variabel untuk pembelajaran; persamaannya tetap sama dengan contoh produksi susu asli.
\[\log(\text{services}) = \beta_0 + \beta_1\log(\text{clinical support cost}) + \beta_2\log(\text{utilities cost}) + \beta_3\log(\text{capacity proxy}) + v - u\]
Keterangan: \(v\) adalah gangguan acak dua sisi, sedangkan \(u\geq0\) adalah komponen inefisiensi dalam asumsi SFA. Sebelum estimasi, kode membuat matriks output y dan matriks input x. select() memilih kolom, sedangkan as.matrix() mengubahnya menjadi bentuk yang diterima fungsi frontier::sfa().
# Chunk B6.10
# Menentukan Matrix variabel input (x) dan output (y) untuk spesifikasi fungsi produksi
y <- healthExample %>% select(services) %>% as.matrix()
x <- healthExample %>% select(clinical_support_cost, utilities_cost, beds_proxy) %>% as.matrix()
# Menghitung nilai efisiensi menggunakan package frontier
healthProd <- frontier::sfa(log(y) ~ log(x))
# Menyimpan nilai efisiensi teknis dari hasil analisis SFA dg production function
teProd <- efficiencies(healthProd)
data.frame(facility_id = healthExample$facility_id,
           efficiency_production = round(teProd, 3))
#> facility_id efficiency
#> 1 1 0.899
#> 2 2 0.915
#> 3 3 0.960
#> 4 4 0.929
#> 5 5 0.934
#> 6 6 0.739
#> 7 7 0.746
#> 8 8 0.895
#> 9 9 0.700
#> 10 10 0.866
#> 11 11 0.888
#> 12 12 0.647
#> 13 13 0.955
#> 14 14 0.909
#> 15 15 0.866
#> 16 16 0.920
#> 17 17 0.791
#> 18 18 0.963
#> 19 19 0.825
#> 20 20 0.892
#> 21 21 0.888
#> 22 22 0.889
#> 23 23 0.676
#> 24 24 0.943
#> 25 25 0.861
#> 26 26 0.878
#> 27 27 0.763
#> 28 28 0.952
#> 29 29 0.939
#> 30 30 0.873
#> 31 31 0.906
#> 32 32 0.921
#> 33 33 0.882
#> 34 34 0.979
#> 35 35 0.629
#> 36 36 0.839
#> 37 37 0.844
#> 38 38 0.855
#> 39 39 0.810
#> 40 40 0.917
#> 41 41 0.588
#> 42 42 0.844
#> 43 43 0.838
#> 44 44 0.872
#> 45 45 0.871
#> 46 46 0.640
#> 47 47 0.897
#> 48 48 0.820
#> 49 49 0.896
#> 50 50 0.931
#> 51 51 0.916
#> 52 52 0.939
#> 53 53 0.783
#> 54 54 0.847
#> 55 55 0.650
#> 56 56 0.811
#> 57 57 0.830
#> 58 58 0.961
#> 59 59 0.900
#> 60 60 0.896
#> 61 61 0.915
#> 62 62 0.877
#> 63 63 0.916
#> 64 64 0.932
#> 65 65 0.653
#> 66 66 0.971
#> 67 67 0.822
#> 68 68 0.826
#> 69 69 0.930
#> 70 70 0.836
#> 71 71 0.885
#> 72 72 0.897
#> 73 73 0.954
#> 74 74 0.857
#> 75 75 0.760
#> 76 76 0.863
#> 77 77 0.932
#> 78 78 0.773
#> 79 79 0.935
#> 80 80 0.803
#> 81 81 0.962
#> 82 82 0.950
#> 83 83 0.976
#> 84 84 0.939
#> 85 85 0.754
#> 86 86 0.666
#> 87 87 0.572
#> 88 88 0.886
#> 89 89 0.851
#> 90 90 0.934
#> 91 91 0.733
#> 92 92 0.659
#> 93 93 0.964
#> 94 94 0.936
#> 95 95 0.879
#> 96 96 0.897
#> 97 97 0.908
#> 98 98 0.675
#> 99 99 0.949
#> 100 100 0.955
#> 101 101 0.908
#> 102 102 0.828
#> 103 103 0.867
#> 104 104 0.928
#> 105 105 0.964
#> 106 106 0.884
#> 107 107 0.921
#> 108 108 0.858Berbeda dengan contoh yang diberikan pada bagian A, estimasi nilai efisiensi dilakukan menggunakan fungsi “sfa()” dari paket “frontier”, bukan dari paket “benchmarking”. Hal ini dilakukan karena variabel input dan/atau output yang digunakan lebih dari satu. Karena namanya sama, pada tahap ini fungsi yang digunakan harus diperjelas dengan menyebutkan nama paketnya sehingga menjadi “frontier::sfa()”. Secara umum, spesifikasi atau parameter dasar dari fungsi ini sama dengan yang ada pada paket “benchmarking”, yaitu “sfa(y ~ x)”. perintah tersebut akan menghasilkan objek hasil analisis SFA dengan nama “healthProd”. Selanjutnya, nilai efisiensi berdasarkan fungsi produksi disimpan sebagai sebuah vektor dengan nama “teProd” menggunakan fungsi“efficiencies()”. Tabel keluaran menampilkan skor setiap fasilitas contoh agar pembaca dapat langsung melihat hasil estimasi.
Alternatif bentuk fungsional yang lain, yaitu dengan memodelkan hubungan variabel input dan output dengan fungsi jarak (distance function). Secara matematis, hal tersebut dapat dituliskan sebagai berikut.
\[\log\left(\frac{1}{\text{beds proxy}}\right) = \alpha_0 + \alpha_1\log\left(\frac{\text{utilities cost}}{\text{beds proxy}}\right) + \alpha_2\log\left(\frac{\text{clinical support cost}}{\text{beds proxy}}\right) + \alpha_3\log(\text{services}) + v - u\]
Pada implementasinya, matriks baru yang mewakili variabel-variabel input (x) dan output (y) perlu didefinisikan terlebih dahulu. Hal ini dapat dilakukan menggunakan fungsi “transmute()” dari paket “dplyr” seperti yang ada pada perintah berikut. Fungsi “transmute()” tersebut mirip dengan fungsi “mutate()” yang sudah digunakan sebelumnya, tetapi fungsi ini akan menghasilkan variabel baru dan menghapus variabel-variabel lama yang ada pada dataset.
# Chunk B6.11
# Menentukan variabel input (x) dan output (y) untuk spesifikasi fungsi jarak
Y <- healthExample %>% transmute(inv_beds_proxy = 1 / beds_proxy) %>%
  as.matrix()
X <- healthExample %>% transmute(
  clinical_support_per_bed = clinical_support_cost / beds_proxy,
  utilities_per_bed = utilities_cost / beds_proxy,
  services = services
) %>% as.matrix()
Selanjutnya, fungsi “frontier::sfa()” kembali digunakan, namun dengan variabel input dan output yang berbeda. Perintah di bawah ini akan menghasilkan objek hasil analisis SFA dengan nama “milkDist”. Selanjutnya, nilai efisiensi berdasarkan fungsi produksi disimpan sebagai sebuah vektor dengan nama “teDist” menggunakan fungsi “efficiencies()”.
CatatanCatatan edisi daring
Pada edisi cetak, matriks untuk fungsi jarak diberi nama y dan x (huruf kecil), sedangkan estimasi di bawah memakai Y dan X (huruf besar). Karena R membedakan huruf besar-kecil, nama matriks di atas diseragamkan menjadi Y dan X.
# Chunk B6.12
# Menghitung nilai efisiensi
healthDist <- frontier::sfa(log(Y) ~ log(X))
# Menyimpan nilai efisiensi teknis dari hasil analisis SFA dengan production function
teDist <- efficiencies(healthDist)
data.frame(facility_id = healthExample$facility_id,
           efficiency_distance = round(teDist, 3))
#> facility_id efficiency
#> 1 1 0.887
#> 2 2 0.931
#> 3 3 0.963
#> 4 4 0.937
#> 5 5 0.928
#> 6 6 0.758
#> 7 7 0.785
#> 8 8 0.866
#> 9 9 0.708
#> 10 10 0.857
#> 11 11 0.910
#> 12 12 0.676
#> 13 13 0.955
#> 14 14 0.912
#> 15 15 0.836
#> 16 16 0.910
#> 17 17 0.829
#> 18 18 0.956
#> 19 19 0.851
#> 20 20 0.903
#> 21 21 0.876
#> 22 22 0.891
#> 23 23 0.683
#> 24 24 0.949
#> 25 25 0.880
#> 26 26 0.897
#> 27 27 0.764
#> 28 28 0.926
#> 29 29 0.970
#> 30 30 0.873
#> 31 31 0.863
#> 32 32 0.909
#> 33 33 0.861
#> 34 34 0.975
#> 35 35 0.699
#> 36 36 0.867
#> 37 37 0.894
#> 38 38 0.869
#> 39 39 0.842
#> 40 40 0.913
#> 41 41 0.669
#> 42 42 0.858
#> 43 43 0.826
#> 44 44 0.861
#> 45 45 0.892
#> 46 46 0.663
#> 47 47 0.923
#> 48 48 0.860
#> 49 49 0.917
#> 50 50 0.933
#> 51 51 0.917
#> 52 52 0.947
#> 53 53 0.895
#> 54 54 0.858
#> 55 55 0.688
#> 56 56 0.802
#> 57 57 0.830
#> 58 58 0.972
#> 59 59 0.921
#> 60 60 0.904
#> 61 61 0.922
#> 62 62 0.873
#> 63 63 0.909
#> 64 64 0.931
#> 65 65 0.696
#> 66 66 0.972
#> 67 67 0.848
#> 68 68 0.864
#> 69 69 0.930
#> 70 70 0.866
#> 71 71 0.934
#> 72 72 0.927
#> 73 73 0.949
#> 74 74 0.855
#> 75 75 0.796
#> 76 76 0.878
#> 77 77 0.949
#> 78 78 0.815
#> 79 79 0.935
#> 80 80 0.824
#> 81 81 0.962
#> 82 82 0.950
#> 83 83 0.978
#> 84 84 0.948
#> 85 85 0.812
#> 86 86 0.707
#> 87 87 0.590
#> 88 88 0.884
#> 89 89 0.903
#> 90 90 0.929
#> 91 91 0.818
#> 92 92 0.674
#> 93 93 0.962
#> 94 94 0.945
#> 95 95 0.871
#> 96 96 0.903
#> 97 97 0.886
#> 98 98 0.707
#> 99 99 0.962
#> 100 100 0.962
#> 101 101 0.944
#> 102 102 0.853
#> 103 103 0.909
#> 104 104 0.958
#> 105 105 0.957
#> 106 106 0.888
#> 107 107 0.922
#> 108 108 0.888Tahap 3. Membandingkan Hasil SFA dari Dua Spesifikasi yang Berbeda
Setelah melakukan estimasi nilai efisiensi menggunakan dua alternatif bentuk fungsional (fungsi produksi dan fungsi jarak), kita akan membandingkan hasil keduanya dengan melihat secara visual. Caranya, nilai efisiensi dari fungsi produksi dan fungsi jarak diplotkan dalam suatu scatter-plot serta dibandingkan dengan suatu garis yang memiliki kemiringan atau slope 1 dan intercept 0 (artinya kedua nilai sama persis). Adapun skrip yang bisa dijalankan, yaitu sebagai berikut. Sekali lagi, grafik ini dibuat menggunakan fungsi “geom_point()” untuk membuat scatter-plot dan fungsi “geom_abline()” untuk membuat garis lurus seperti yang sudah pernah dibahas pada bagian-bagian sebelumnya. Sebagai tambahan, yaitu pengguna bisa menambahkan pilihan tema dari grafik yang dihasilkan. Pada perintah ini, tema yang dipilih adalah “theme_classic()”. Pilihan lain yang bisa digunakan dapat dilihat pada laman https://ggplot2.tidyverse.org/reference/ggtheme.html.
# Chunk B6.13
# Membuat grafik korelasi antara nilai efisiensi dari Distance Function dan Production Function
ggplot() +
  geom_point(mapping = aes(x=teDist, y=teProd)) +
  geom_abline(intercept=0, slope=1) +
  theme_classic()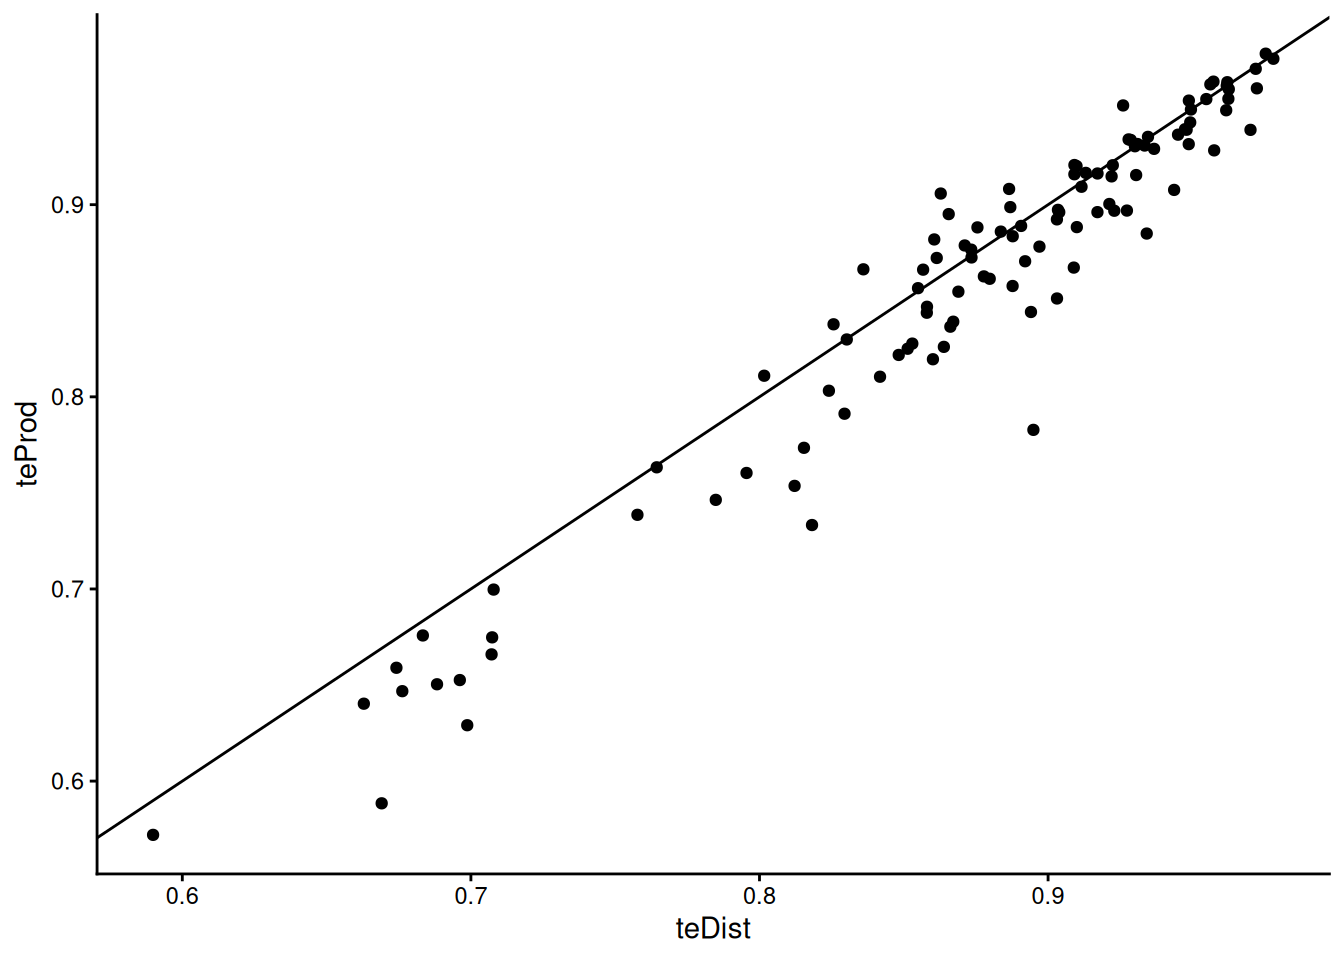
Grafik korelasi antara skor efisiensi yang diestimasi menggunakan fungsi produksi (sumbu vertikal) dan fungsi jarak (sumbu horizontal) dapat dilihat pada Gambar 6.4. Terlihat bahwa tingkat korelasinya sangat tinggi (mendekati garis diagonal). Hal ini kemungkinan disebabkan oleh kedua spesifikasi menggunakan data contoh yang sama dan hanya cara estimasinya berbeda. Nama analitis kesehatan membantu membaca contoh, tetapi asal data tetap produksi susu Denmark (Bogetoft dan Otto, 2010).
6.3 Aplikasi pada Data Rumah Sakit di Indonesia
Setelah melakukan estimasi nilai efisiensi dengan teknik SFA pada data contoh, selanjutnya akan dilakukan aplikasi pada data rumah sakit.
Tahap 1. Membuka Dataset
Seperti yang sudah dilakukan pada bagian-bagian sebelumnya, analisis ini dimulai dengan membuka/mengimpor dataset hospital ke dalam Environment dengan perintah/script di bawah ini. Selanjutnya, pembaca dapat melakukan pelabelan terhadap variabel-variabel dan nilai yang ada pada data tersebut dengan mengikuti langkah yang telah dijelaskan pada Bab III bagian D.
# Chunk B6.14
# Mengaktifkan package
library(tidyverse)
# Membuka data dengan format csv
hospital <- read_csv(
  "https://raw.githubusercontent.com/fikrurizal/buku-efisiensi/main/data/hospital.csv"
)
Kode pelabelan data (lihat Bab III)
# Chunk B6.15
hospital <- hospital %>%
  set_variable_labels(
    id_rs = "ID Rumah Sakit", gp_FTE = "Jumlah Dokter Umum",
    spec_FTE = "Jumlah Dokter Spesialis", nurse_total = "Jumlah Perawat",
    other_prof = "Jumlah Karyawan Lain", beds = "Jumlah Bed",
    outpatients = "Jumlah Kunjungan Rajal", bed_days = "Total Bed Days",
    admissions1 = "Jumlah Admisi", bed_occ = "Bed Occupancy",
    throughput = "Throughput", alos = "Average Length of Stay",
    totalcost_op = "Total Biaya Rajal", total_cost_bd = "Total Biaya Bed Days",
    totalcost_ip = "Total Biaya Ranap", publichospital = "Kepemilikan",
    poorins = "Proporsi Jamkesmas", classCD = "Kelas", non_JavaBali = "Lokasi") %>%
  set_value_labels(
    publichospital = c("Pemerintah" = 1, "Swasta" = 0),
    classCD = c("Kelas C/D" = 1, "Kelas A/B" = 0),
    non_JavaBali = c("Non Java-Bali" = 1, "Java-Bali" = 0)) %>%
  to_factor()
Tahap 2. Estimasi Nilai Efisiensi
Selanjutnya, kita akan melakukan estimasi nilai efisiensi menggunakan persamaan yang paling sederhana, yaitu fungsi produksi Cobb-Douglas. Variabel yang digunakan berupa jumlah admisi rawat inap (admissions1) sebagai output. Sementara untuk input, yaitu variabel jumlah dokter umum penuh waktu (gp_FTE), jumlah dokter spesialis penuh waktu (spec_FTE), jumlah perawat (nurse_total), serta jumlah tempat tidur (beds). Secara formal, model tersebut dapat dituliskan sebagai berikut.
\[ \begin{aligned} \log(\text{admissions1}) ={}& \beta_0 + \beta_1\log(\text{gp\_FTE}) + \beta_2\log(\text{spec\_FTE})\\ &+ \beta_3\log(\text{nurse\_total}) + \beta_4\log(\text{beds}) + (v_i - u_i) \end{aligned} \]
Untuk aplikasi di konsol R, langkah pertama yang harus dilakukan, yaitu mendefinisikan matriks untuk variabel input (x1) dan output (y1) dengan skrip sebagai berikut.
# Chunk B6.16
# Menentukan matrix variabel x dan y
x <- hospital %>% select(gp_FTE, spec_FTE, nurse_total, beds) %>%
  as.matrix()
y <- hospital %>% select(admissions1) %>% as.matrix()
Selanjutnya, pada skrip di bawah ini, model SFA diestimasi terlebih dahulu menggunakan fungsi “frontier::sfa()” yang menghasilkan objek dengan nama “prod_inp”, dilanjutkan dengan ekstraksi nilai efisiensi dengan perintah “efficiencies” yang diberi nama “teProd”.
# Chunk B6.17
# SFA dengan Production Function
prod_inp <- frontier::sfa(log(y) ~ log(x))
teProd <- efficiencies(prod_inp) %>%
  as_tibble() %>%
  rename(te_sfa=efficiency)
# Hasil SFA dengan Production Function
summary(teProd)
#> te_sfa
#> Min. :0.03037
#> 1st Qu.:0.45721
#> Median :0.60482
#> Mean :0.59196
#> 3rd Qu.:0.76512
#> Max. :0.93754Tahap 3. Menggabungkan Nilai Efisiensi ke Dataset
Setelah estimasi nilai efisiensi didapatkan, langkah selanjutnya, yaitu menggabungkan variabel tersebut ke dataset utama dengan fungsi “bind_cols()” dari paket “dplyr” seperti di bawah ini, dilanjutkan dengan memberi label pada variabel yang baru saja dimasukkan menggunakan fungsi “var_label() <-” dari paket “labelled”.
# Chunk B6.18
# Merge hasil efisiensi dengan data master
hospital_sfa <- bind_cols(hospital, teProd)
# Membuat label
var_label(hospital_sfa$te_sfa) <- "Efisiensi Teknis (SFA)"
Tahap 4. Analisis Variabel Kontekstual
Untuk mengetahui faktor-faktor kontekstual apa yang berpengaruh terhadap skor efisiensi, pada tahap ini kita akan melakukan analisis bivariat dan multivariat. Analisis bivariat bertujuan untuk membandingkan (rerata) skor efisiensi berdasarkan suatu variabel kontekstual tertentu, misalnya berdasarkan kepemilikan rumah sakit. Sementara itu, analisis multivariat bertujuan untuk mengetahui hubungan antara lebih dari satu variabel kontekstual dengan estimasi skor efisiensi secara simultan.
Analisis Bivariat
Pada tahap ini, kita dapat melihat perbedaan rerata skor efisiensi dengan menampilkan grafik box-plot menggunakan paket “ggplot2” seperti yang sudah dijelaskan pada bagian-bagian sebelumnya. Adapun contoh yang disajikan dalam hal ini, yaitu lokasi dan jenis rumah sakit.
# Chunk B6.19
# Membuat box-plot Lokasi
hospital_sfa %>%
  ggplot() +
  geom_boxplot(mapping = aes(x=non_JavaBali, y=te_sfa)) +
  labs(x ="Lokasi", y ="Nilai Efisiensi Teknis")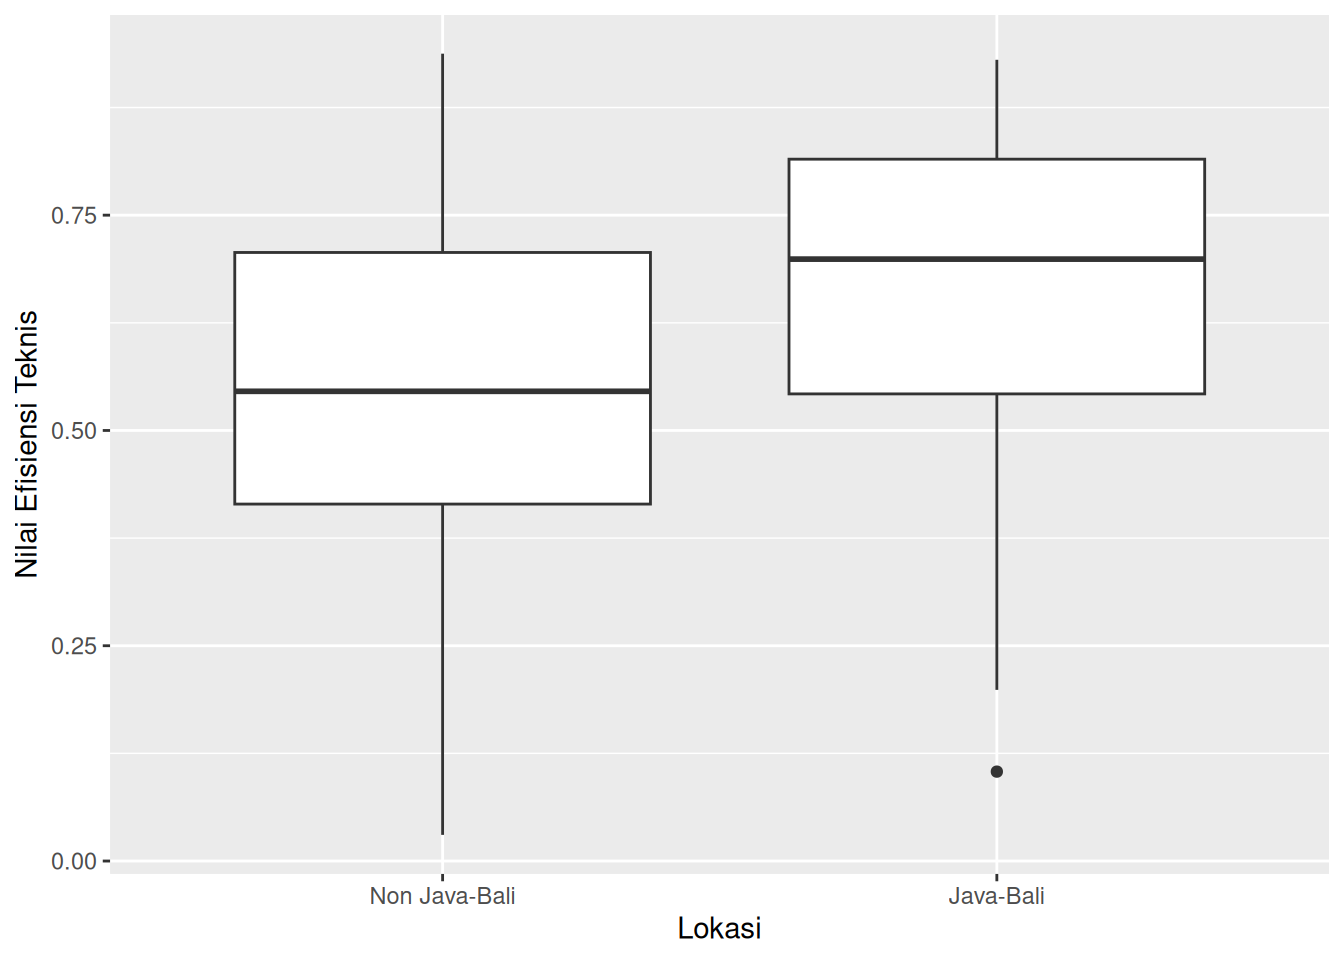
# Chunk B6.20
# Membuat box-plot Kepemilikan
hospital_sfa %>%
  ggplot() +
  geom_boxplot(mapping = aes(x=publichospital, y=te_sfa)) +
  labs(x ="Kepemilikan", y ="Nilai Efisiensi Teknis")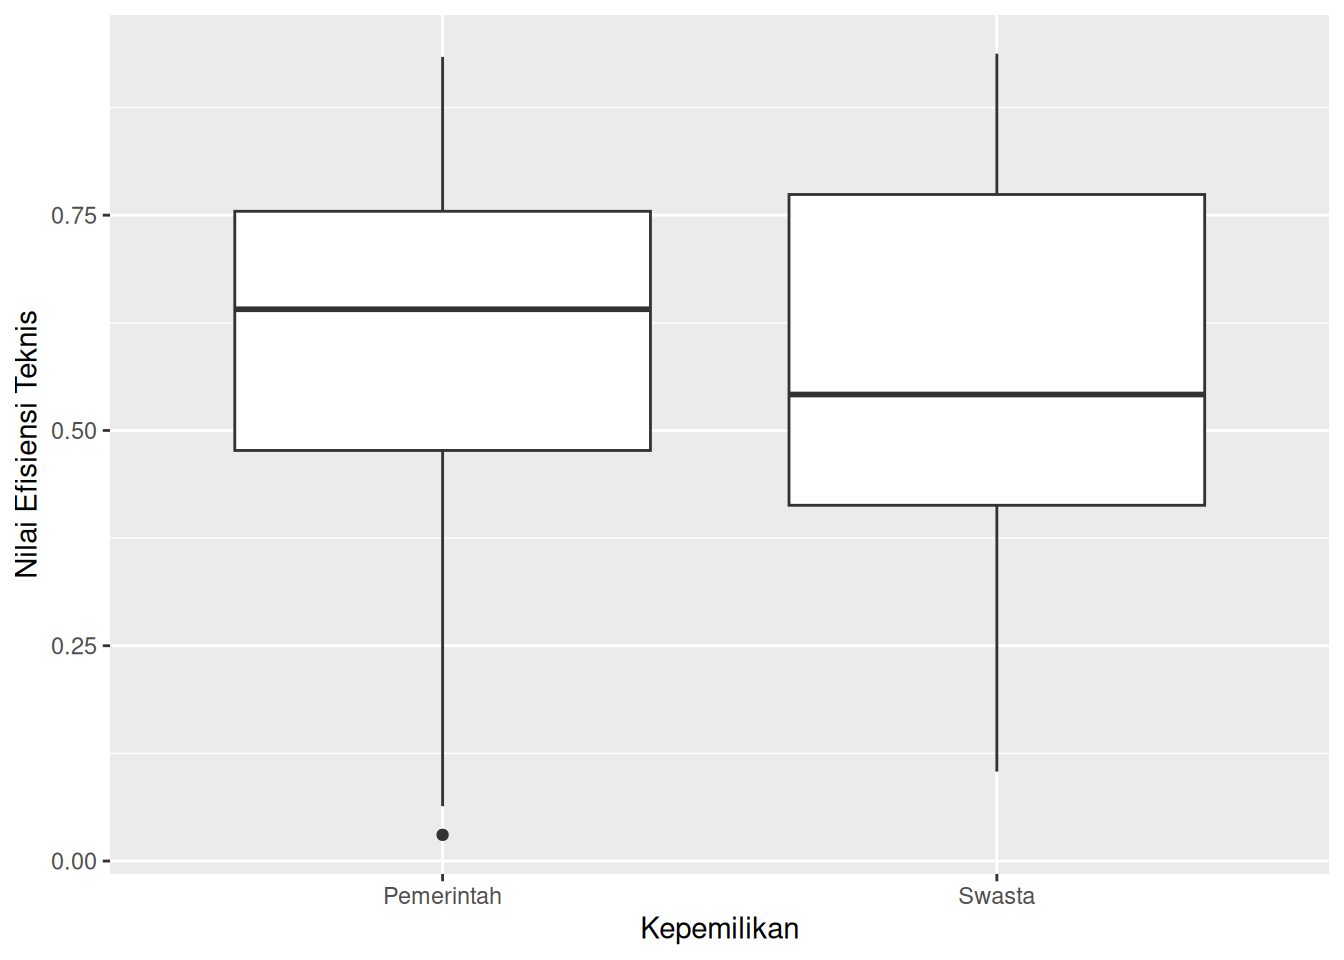
Berdasarkan Gambar 6.5, secara visual dapat dilihat bahwa skor efisiensi rumah sakit yang ada di Pulau Jawa dan Bali lebih tinggi dibandingkan dengan yang lainnya. Sementara itu, berdasarkan Gambar 6.6, secara sekilas terlihat bahwa skor efisiensi rumah sakit pemerintah lebih tinggi dibandingkan dengan swasta.
Selanjutnya, dapat dilakukan analisis statistik menggunakan uji t tidak berpasangan dengan asumsi varians yang tidak sama. Analisis ini dilakukan menggunakan fungsi “tbl_summary()” dari paket “gtsummary”. Fungsi “add_p(all_continuous() ~ “t.test”)” digunakan untuk menambahkan nilai p pada uji statistik beda rerata. Hasilnya dapat dilihat bahwa perbedaan rerata skor efisiensi berdasarkan lokasi menunjukkan hasil yang secara statistik signifikan (p < 0,001). Sementara itu, untuk jenis kepemilikan, uji t tidak menunjukkan hasil yang secara statistik signifikan.
# Chunk B6.21
# T-test tidak berpasangan berdasarkan lokasi
hospital_sfa %>%
  select(te_sfa, non_JavaBali) %>%
  tbl_summary(
  by = non_JavaBali,
  statistic = all_continuous() ~ "{mean} ({sd})") %>%
  add_p(all_continuous() ~ "t.test") %>%
  as_flex_table()
Characteristic | Non Java-Bali | Java-Bali | p-value2 |
|---|---|---|---|
Efisiensi Teknis (SFA) | 0.55 (0.21) | 0.66 (0.20) | <0.001 |
1Mean (SD) | |||
2Welch Two Sample t-test | |||
# T-test tidak berpasangan berdasarkan kepemilikan
hospital_sfa %>%
  select(te_sfa, publichospital) %>%
  tbl_summary(by=publichospital,
  statistic = all_continuous() ~ "{mean} ({sd})") %>%
  add_p(all_continuous() ~ "t.test") %>%
  as_flex_table()
Characteristic | Pemerintah | Swasta | p-value2 |
|---|---|---|---|
Efisiensi Teknis (SFA) | 0.61 (0.21) | 0.57 (0.22) | 0.2 |
1Mean (SD) | |||
2Welch Two Sample t-test | |||
Analisis Multivariat
Untuk memahami pengaruh faktor-faktor kontekstual secara menyeluruh, perlu dilakukan analisis multivariabel. Tidak seperti analisis DEA yang dilakukan secara dua tahap, hubungan variabel-variabel kontekstual dengan tingkat efisiensi dapat dianalisis dengan satu tahap saja. Dalam hal ini, kita akan menggunakan fungsi “sfa()” yang tersedia pada package “frontier” seperti yang dilakukan pada Tahap 2 dengan menambahkan parameter “|” dilanjutkan dengan daftar variabel kontekstual yang akan diuji (“non_JavaBali + classCD + publichospital”).
# Chunk B6.22
# Membuka data dengan format csv
hospital <- read_csv(
  "https://raw.githubusercontent.com/fikrurizal/buku-efisiensi/main/data/hospital.csv"
)
# Analisis SFA satu tahap dengan variabel kontekstual
faktor_inp <- sfa(
  log(admissions1) ~ log(gp_FTE) + log(spec_FTE) +
    log(nurse_total) + log(beds) | non_JavaBali + classCD +
    publichospital,
  data = hospital)
summary(faktor_inp)
#> Efficiency Effects Frontier (see Battese & Coelli 1995)
#> Inefficiency decreases the endogenous variable (as in a production function)
#> The dependent variable is logged
#> Iterative ML estimation terminated after 120 iterations:
#> log likelihood values and parameters of two successive iterations
#> are within the tolerance limit
#>
#> final maximum likelihood estimates
#> Estimate Std. Error z value Pr(>|z|)
#> (Intercept) 4.5717e+00 2.5582e-01 17.8709 < 2.2e-16 ***
#> log(gp_FTE) -4.3728e-02 5.7977e-02 -0.7542 0.4507
#> log(spec_FTE) -2.3472e-03 2.7125e-02 -0.0865 0.9310
#> log(nurse_total) 1.7256e-01 4.2539e-02 4.0564 4.983e-05 ***
#> log(beds) 8.1387e-01 5.7516e-02 14.1504 < 2.2e-16 ***
#> Z_(Intercept) -1.5700e+02 2.7349e+02 -0.5741 0.5659
#> Z_non_JavaBali 7.3935e+01 1.3062e+02 0.5660 0.5714
#> Z_classCD -4.4027e+00 1.0845e+01 -0.4060 0.6848
#> Z_publichospital -1.6281e+01 3.1131e+01 -0.5230 0.6010
#> sigmaSq 5.4170e+01 9.4500e+01 0.5732 0.5665
#> gamma 9.9913e-01 1.6153e-03 618.5549 < 2.2e-16 ***
#> ---
#> Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#> log likelihood value: -117.5117
#>
#> cross-sectional data
#> total number of observations = 198
#>
#> mean efficiency: 0.6884206Berdasarkan hasil di atas, terlihat bahwa faktor kontekstual tidak ada yang memiliki koefisien yang secara statistik signifikan.
Tambahan: Perbandingan Skor Efisiensi dari DEA dengan SFA
Scatter-plot pada Gambar 6.7 merupakan perbandingan hasil estimasi skor efisiensi dengan teknik DEA dan SFA. Terlihat bahwa sebagian besar rumah sakit memiliki skor efisiensi DEA dan SFA yang relatif sama. Akan tetapi, terdapat beberapa rumah sakit yang memiliki skor efisiensi DEA tinggi, namun memiliki skor efisiensi SFA yang rendah.
CatatanCatatan edisi daring
Edisi cetak tidak menampilkan kode untuk grafik ini. Kode berikut diambil dari R Markdown latihan penulis: skor DEA dihitung ulang dengan spesifikasi yang sama seperti pada Bab V, lalu digabungkan dengan skor SFA.
# Chunk B6.23
library(Benchmarking)
# Skor DEA berorientasi input dengan bootstrap (seperti Bab V)
x_dea <- hospital_sfa %>% select(gp_FTE, nurse_total, other_prof, beds) %>% as.matrix()
y_dea <- hospital_sfa %>% select(outpatients, admissions1) %>% as.matrix()
set.seed(2021)
dea_input <- dea.boot(x_dea, y_dea, NREP = 100, RTS = "vrs", ORIENTATION = "in")
hospital_all <- hospital_sfa %>% mutate(EI_bc = dea_input$eff.bc)

# Rerata nilai efisiensi dari SFA dan DEA
mean_sfa <- mean(hospital_all$te_sfa)
mean_dea <- mean(hospital_all$EI_bc)

# Scatter plot hasil estimasi DEA vs SFA
hospital_all %>% ggplot() +
  geom_point(mapping = aes(y = te_sfa, x = EI_bc)) +
  geom_hline(yintercept = mean_sfa) +
  geom_vline(xintercept = mean_dea) +
  labs(title = "Perbandingan DEA dan SFA", x = "DEA", y = "SFA")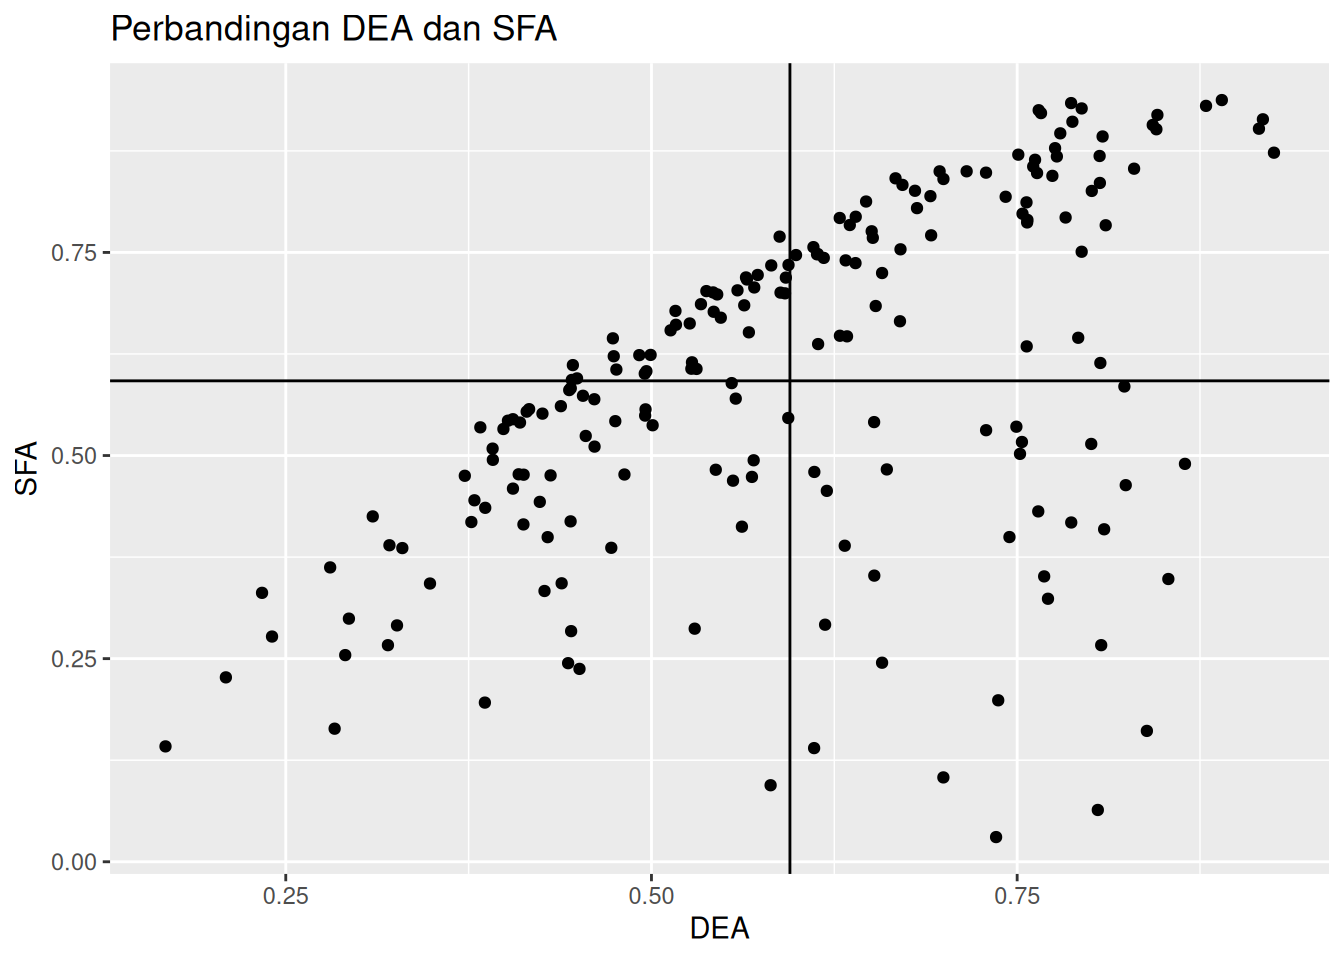
Plot di atas juga dapat digunakan jika peneliti atau pengambil kebijakan ingin menentukan rumah sakit mana yang dapat dikategorisasikan efisien, baik diukur dengan DEA maupun SFA. Caranya, yaitu dengan membaginya menjadi empat kuadran berdasarkan skor rata-rata pada masing-masing sumbu. Dengan demikian, rumah sakit yang berada pada kuadran kanan atas dapat dinilai sebagai rumah sakit yang efisien.
6.4 Kesimpulan
SFA merupakan salah satu jenis teknik pengukuran efisiensi dengan metode analisis frontier.
Teknik SFA merupakan metode yang lebih kompleks dibandingkan DEA.
Terdapat beberapa packages yang diperlukan untuk melakukan analisis SFA pada program R, yaitu: benchmarking dan frontier.