Dalam melakukan analisis efisiensi fasilitas kesehatan, selain pengetahuan mengenai metodologi dan aplikasinya, peneliti juga harus memahami isu-isu yang terkait. Beberapa di antaranya, yaitu pengetahuan tentang sumber data yang bisa digunakan, aspek persiapan data, permasalahan etik, dan permasalahan metodologis yang lebih dalam. Dengan begitu, peneliti dapat melakukan analisis secara lebih baik dan bertanggung jawab, mampu menginterpretasikan hasil sesuai dengan konteks, serta menyadari adanya kekurangan dalam analisis yang dibuatnya. Oleh karena itu, bab ini akan memberikan penjelasan secara ringkas mengenai isu-isu penting yang belum dibahas pada bab-bab sebelumnya.
7.1 Sumber Data
Pada latihan analisis efisiensi yang ada dalam Bab IV sampai dengan VI, pembaca sudah diberikan dataset yang lengkap dan bersih. Akan tetapi, pada kenyataannya, ketika melakukan analisis efisiensi secara mandiri, pembaca akan dihadapkan pada kenyataan bahwa tahap pertama yang harus dilakukan adalah mencari sumber data yang tepat. Proses tersebut dapat berupa pengumpulan data mandiri (menggunakan data primer) maupun menggunakan data sekunder (dari survei yang sudah dilakukan oleh pihak lain ataupun data administratif).
Pengumpulan data secara mandiri akan memakan sumber daya yang lebih besar. Akan tetapi, dari segi kelengkapan variabel dan kualitasnya, data primer cenderung lebih mudah dikendalikan oleh peneliti. Sementara itu, dengan data sekunder, sumber daya yang digunakan akan lebih sedikit, namun perlu disadari bahwa ketersediaan variabel dan kualitas data tidak bisa sepenuhnya dikendalikan oleh peneliti. Di sisi lain, penggunaan sumber data sekunder justru bisa meningkatkan kebermanfaatan dari survei yang sudah dilakukan sebelumnya. Oleh karena itu, bagian ini akan lebih fokus pada penjelasan mengenai data sekunder yang tersedia di Indonesia. Data tersebut di antaranya sebagai berikut.
Riset Pembiayaan Fasilitas Kesehatan
Kementerian Kesehatan Indonesia (Kemenkes) melakukan Riset Pembiayaan Fasilitas Kesehatan Nasional atau Health Facility Costing Study (HFCS) pada tahun 2010. Tujuan utama dari penelitian ini, yaitu untuk memberikan pemahaman yang lebih baik tentang biaya pemberian layanan kesehatan di seluruh negeri. Studi prospektif dilakukan antara Oktober 2010 dan September 2011 di 15 provinsi dan 30 kabupaten di Indonesia. Sampel fasilitas kesehatan dipilih melalui proses stratified random sampling (Ensor dan Indradjaya, 2012). Survei mengumpulkan data tentang layanan, sumber daya (infrastruktur, peralatan, staf, obat-obatan, dan persediaan medis), dan pengeluaran (misalnya biaya perlengkapan kantor, pemeliharaan, dan transportasi) untuk 234 puskesmas (3%) dan 202 rumah sakit (12%) (Kemenkes, 2012e).
Survei Sosioekonomi Nasional
Survei Sosioekonomi Nasional (Susenas) merupakan serangkaian survei sosial ekonomi multiguna skala besar yang dilakukan di Indonesia. Ini merupakan sampel perwakilan kabupaten. Pada tahun 2011, Susenas mencakup sampel yang representatif secara nasional, terdiri atas 300.000 rumah tangga dari 33 provinsi dan 497 kabupaten di seluruh Indonesia. Survei ini terdiri atas daftar rumah tangga dan informasi tambahan tentang perawatan kesehatan dan gizi, pendapatan rumah tangga, pengeluaran, pengalaman angkatan kerja, dan lain-lain.
Survei Potensi Desa
Statistik Potensi Desa (Podes) memberikan informasi tentang karakteristik desa untuk seluruh Indonesia. Podes adalah sensus yang menyediakan informasi tentang karakteristik desa di seluruh Indonesia, meliputi jumlah populasi, sumber utama pendapatan keluarga, ketersediaan dan akses ke fasilitas kesehatan, dan tingkat kematian. Pada tahun 2011, data dikumpulkan dari 77.126 desa di 6.651 kecamatan dan 497 kabupaten. Sensus infrastruktur juga dilakukan untuk mengumpulkan informasi tentang infrastruktur publik, termasuk lembaga kesehatan di desa. Jenis fasilitas kesehatan yang dicatat, yaitu layanan kesehatan primer, pos kesehatan desa, pos kesehatan persalinan, dan pos kesehatan terpadu.
Dataset Indonesia Case-Based Group (INA-CBGs)
Sejak 2007, sistem diagnosis-related group (DRG), yaitu Indonesia Case Base Group (INA-CBGs), telah digunakan untuk mengganti biaya rumah sakit di bawah skema Jamkesmas. Dataset INA-CBGs berisi informasi tingkat pasien yang terkait dengan demografi pasien, diagnosis, dan tarif penggantian. Data tingkat pasien dalam dataset INA-CBGs tidak dapat digunakan dengan model bertingkat dalam tesis ini karena data terbatas pada rumah sakit yang dikontrak dalam skema Jamkesmas (hanya 60% dari sampel dicocokkan dengan dataset HFCS sebagai dataset utama).
Namun, variabel kunci berupa kode DRG, tarif DRG, dan jenis pembuangan yang berguna untuk mewakili kerumitan pasien di rumah sakit. Untuk mempertimbangkan beban penyakit dan kualitas, keluaran rumah sakit disesuaikan menggunakan case-mix index (CMI) dan rasio kematian (Witter et al., 2000; AHRQ, 2013).
Data Sampel BPJS Kesehatan
Pada tahun 2018, BPJS Kesehatan mengeluarkan data sampel pelayanan Jaminan Kesehatan Nasional tahun 2015–2016. Data ini berisi karakteristik peserta dan klaim pelayanan kesehatan di semua tingkat dari 1% peserta yang tercatat aktif terdaftar pada tanggal 31 Desember 2015. Pengambilan sampel dilakukan melalui metode stratified random sampling dengan strata dari kombinasi variabel tempat FKTP terdaftar dan kategori keluarga berdasarkan pemanfaatan pelayanan kesehatan.
Set data ini terdiri atas data sampel kepesertaan, data sampel pelayanan FKTP (fasilitas kesehatan tingkat pertama) kapitasi dan nonkapitasi, serta data sampel pelayanan FKRTL (fasilitas kesehatan rujukan tingkat lanjut). Sampel ini berisi observasi pada 1.697.452 individu, 1.733.759 pelayanan FKTP kapitasi, 104.456 pelayanan FKTP nonkapitasi, dan 906.905 pelayanan FKRTL. Secara ringkas, sumber data yang sudah dijelaskan tersebut dapat dirangkum pada tabel berikut.
Tabel 7.1: Rangkuman informasi terkait sumber data potensial untuk melakukan analisis efisiensi
Data
Keterangan
Tahun
Penggunaan
HFCS
Fasilitas kesehatan (RS dan puskesmas)
2010
Variabel input dan output per fasilitas kesehatan
Susenas
Individu dan rumah tangga se-Indonesia
1976, tiap tahun sejak 1978
Variabel kontekstual: tingkat pendidikan, tingkat kemiskinan, cakupan jaminan kesehatan, dan lain-lain
Podes
Desa seluruh Indonesia
Sejak 1983, tiap 3–4 tahun
Variabel kontekstual: jumlah fasilitas kesehatan dan tenaga kesehatan, ketersediaan infrastruktur
INA-CBGs
Data INA-CBGs per kasus per rumah sakit
Sejak tahun 2007
Variabel indeks casemix (bauran kasus)
Data Sampel BPJS
Sampel data klaim dari 1% peserta JKN
2015–2016
Rasio utilisasi peserta JKN, satuan biaya pelayanan per kasus atau kelompok kasus, dan indeks casemix di level kabupaten/kota
7.2 Persiapan Data
Dengan banyaknya sumber data sekunder yang bisa dimanfaatkan, peneliti perlu melakukan persiapan data terlebih dahulu sebelum masuk pada analisis. Tahapan ini biasanya dimulai dengan mengidentifikasi variabel-variabel yang dibutuhkan dan mengidentifikasi sumber data yang memungkinkan. Seringnya, peneliti harus menggabungkan beberapa sumber data dengan pertimbangan tertentu untuk mendapatkan variabel lengkap sesuai yang dibutuhkan. Oleh karena itu, tahapan ini merupakan hal yang cukup penting dalam melakukan semua jenis analisis, termasuk pengukuran efisiensi fasilitas kesehatan.
7.3 Isu Metodologi
Isu ketiga yang penting untuk dipahami adalah aspek metodologis di luar pengetahuan mengenai teknik analisis efisiensi itu sendiri. Bagian ini akan membahas tentang penggunaan indeks bauran kasus atau casemix index yang dapat digunakan sebagai faktor penyesuai (adjustment factor) saat melakukan pengukuran output, penyederhanaan pengukuran variabel kontekstual, serta isu-isu terkait keterbatasan penelitian.
Penggunaan Casemix Index
Pada beberapa bagian buku ini, sudah sering disinggung mengenai casemix index (CMI) atau indeks bauran kasus (IBK) sebagai variabel yang dapat mewakili kompleksitas pelayanan yang diberikan oleh suatu fasilitas kesehatan. CMI yang lebih tinggi menandakan pasien dengan kasus yang lebih kompleks dirawat dengan cara mengonsumsi sumber daya kesehatan yang lebih besar. Volume pasien CMI yang disesuaikan memungkinkan perbandingan di rumah sakit. Tarif rata-rata setiap kelompok kasus dasar bagi semua rumah sakit digunakan untuk memperkirakan CMI.
Karena ada tarif yang berbeda untuk setiap kelas rumah sakit di Indonesia, penulis menggunakan tarif rata-rata untuk setiap kelompok kasus bagi semua rumah sakit. Kemudian, CMI untuk rumah sakit (k) dihitung menggunakan persamaan berikut untuk layanan rawat jalan dan rawat inap.
Adapun tarifk adalah tarif rata-rata untuk DRG k, dan Mki adalah jumlah pasien dengan DRG k di rumah sakit i.
Indikator kualitas di rumah sakit dapat dibangun menggunakan rasio mortalitas atau angka kematian (mortality ratio). Rasio yang lebih kecil dari satu menunjukkan kualitas yang baik. Rasio mortalitas dihitung menggunakan persamaan berikut.
Adapun mort_ratioi adalah rasio kematian; act_deathi adalah jumlah aktual kematian yang terjadi di rumah sakit i di atas jumlah kematian yang diharapkan di rumah sakit I (exp_mort). Angka kematian rata-rata, death_rate, merupakan jumlah kematian (death) untuk DRG k dibagi jumlah admisi (adm) untuk DRG k. Jumlah admisi dan hari tidur disesuaikan dengan indikator kualitas (tingkat kematian dikali rasio kematian). adj_admissionsi= admissionsi× CMIi× (1 – death_ratei× mort_ratioi)
Rumah sakit dengan rasio kematian yang lebih rendah meningkatkan jumlah pemulangan di rumah sakit, atau rasio kematian yang lebih tinggi mengurangi tingkat kelangsungan hidup. Indeks campuran kasus Jamkesmas dapat mencerminkan campuran kasus rumah sakit karena jumlah penerima manfaatnya yang besar. Rata-rata, berdasarkan HFCS, pasien Jamkesmas mewakili 24% pasien rawat inap dan 14% dari kunjungan rawat jalan. Empat puluh tujuh persen penerima Jamkesmas berada di tiga desil pendapatan terbawah, 32% di desil pendapatan menengah, dan 20% di desil pendapatan tiga teratas (Marzoeki et al., 2014). Dataset dipasok oleh Pusat Pembiayaan Kesehatan dan Asuransi di Departemen Kesehatan Indonesia. Penelitian ini menggunakan dataset INA-CBGs 2011, yang menghubungkannya dengan dataset HFCS menggunakan ID fasilitas kesehatan unik yang dihasilkan oleh Kementerian Kesehatan.
Tutorial R: menyesuaikan output dengan case-mix index
Bagian ini adalah tambahan edisi daring yang mengadaptasi struktur penghitungan case-mix dan penyesuaian mortalitas dari skrip pendamping tesis doktoral penulis (2018). Contoh menggunakan data sintetis, bukan data pasien atau hasil empiris tesis. Karena itu, kode ini mengajarkan alur kerja dan tidak boleh dipakai untuk menyimpulkan kinerja rumah sakit nyata.
Masalah: dua rumah sakit dapat mempunyai jumlah admisi sama, tetapi menangani kasus dengan kerumitan berbeda. Membandingkan angka mentah dapat memberi keuntungan tidak adil pada rumah sakit yang menerima pasien lebih ringan. Tujuan: membuat output layanan yang sudah mempertimbangkan kompleksitas kasus dan kualitas. Metode: tiap rumah sakit menerima CMI dan rasio mortalitas buatan; skor DEA kemudian dibandingkan sebelum dan sesudah penyesuaian.
# Chunk B7.01 — persiapan mandiri dan data latihan Bab VII.source("R/chunk_helpers.R")book_begin_chapter("Bab 7", "Benchmarking")# 1. Membuat data latihan: setiap baris adalah satu rumah sakit buatan.# CMI > 1 berarti rata-rata kasus lebih kompleks daripada rata-rata pembanding.set.seed(2018)rs_cmi <-data.frame(id =sprintf("CMI-%02d", 1:30),doctors =runif(30, 5, 25), nurses =runif(30, 30, 150),beds =runif(30, 30, 250),outpatients =runif(30, 3000, 35000),admissions =runif(30, 500, 6500),bed_days =runif(30, 2500, 50000),surgery =runif(30, 30, 1300),cmi_outpatient =runif(30, 0.80, 1.25),cmi_inpatient =runif(30, 0.80, 1.45),death_rate =runif(30, 0.005, 0.040),mortality_ratio =runif(30, 0.75, 1.25))# 2. Menghitung output terstandar.# pmax() mencegah faktor kualitas nol/negatif akibat data masukan yang tidak layak.rs_cmi$quality_factor <-pmax(0.01,1- rs_cmi$death_rate * rs_cmi$mortality_ratio)rs_cmi$outpatients_adjusted <- rs_cmi$outpatients * rs_cmi$cmi_outpatientrs_cmi$bed_days_adjusted <- rs_cmi$bed_days * rs_cmi$cmi_inpatient * rs_cmi$quality_factorrs_cmi$admissions_adjusted <- rs_cmi$admissions * rs_cmi$cmi_inpatient * rs_cmi$quality_factor# 3. Membandingkan nilai mentah dan nilai yang sudah disesuaikan.head(rs_cmi[c("id", "outpatients", "outpatients_adjusted", "admissions","admissions_adjusted", "cmi_inpatient", "quality_factor")])
Hasil yang diharapkan: tabel pertama menunjukkan perbedaan volume mentah dan volume terstandar. Pada tabel kedua, phi_raw dan phi_adjusted dapat berbeda; pada DEA orientasi output, nilai () adalah faktor ekspansi output menuju frontier. Misalnya, (20) berarti dalam model output perlu meningkat 20% dengan input yang sama. Interpretasi: perubahan skor bukan bukti bahwa rumah sakit sebelumnya dikelola buruk atau baik; skor berubah karena pembanding kini mempertimbangkan kompleksitas dan faktor kualitas yang dimodelkan.
PeringatanBatasan penting
CMI harus dihitung dari kelompok kasus, bobot/tarif referensi, dan periode yang terdokumentasi. Rasio mortalitas harus berbasis model risiko yang tervalidasi, bukan sekadar angka kematian mentah. Jangan mengalikan semua indikator dengan CMI tanpa justifikasi klinis. Hindari pula mengubah nol layanan menjadi data hilang otomatis: nol dapat berarti layanan memang tidak tersedia. DEA sensitif terhadap pencilan, jumlah variabel, dan pilihan kelompok pembanding; lakukan analisis sensitivitas sebelum memakai hasil untuk kebijakan.
Penyusunan Variabel Kontekstual
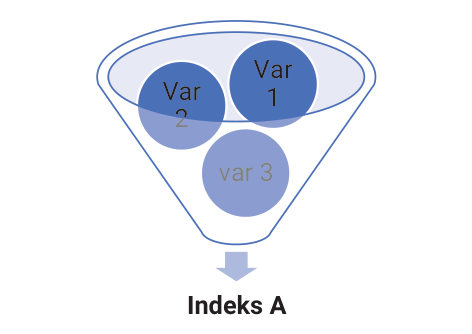
Permasalahan selanjutnya yang perlu diperhatikan, yaitu banyaknya variabel kontekstual yang tersedia dalam dataset dapat meningkatkan potensi terjadinya korelasi yang kuat antarvariabel, terutama saat melakukan analisis regresi multivariat (Everitt dan Hothorn, 2011). Dampaknya, hasil estimasi statistik bisa mengalami bias. Untuk mengatasi masalah tersebut, principal component analysis (PCA) dapat digunakan untuk membuat variabel baru yang lebih sedikit dari beberapa variabel yang saling berkorelasi (Jolliffe et al., 2020).
Caranya, yaitu dengan melakukan pengelompokan variabel sebelum melakukan analisis PCA untuk tujuan interpretasi hasil. Kemudian, dengan melakukan analisis PCA, variabel-variabel tersebut diubah menjadi suatu variabel indeks baru berdasarkan kategori (misalkan indeks gangguan fasilitas kesehatan, indeks manajemen kualitas, indeks kemiskinan, indeks akses ke fasilitas kesehatan, dan indeks pendidikan penduduk). Ilustrasi dapat dilihat pada Gambar 7.1.
Gambar 7.1: Ilustrasi penggunaan principal component analysis (PCA)
Keterbatasan Penelitian
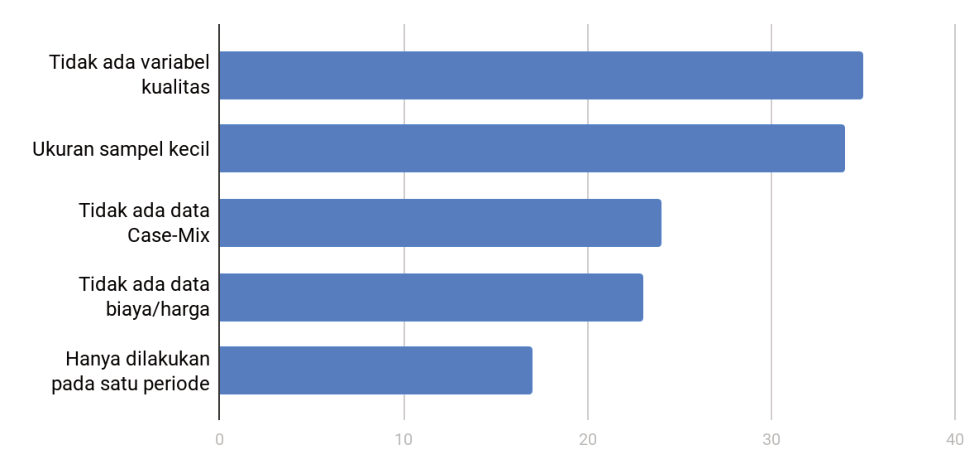
Berdasarkan tinjauan sistematis yang dilakukan oleh Hafidz, Ensor, dan Tubeuf (2018b) terhadap penelitian-penelitian mengenai efisiensi fasilitas kesehatan di negara-negara berkembang, terdapat beberapa keterbatasan penelitian yang perlu diperhatikan. Permasalahan yang paling sering muncul, yaitu tidak tersedianya variabel kualitas fasilitas kesehatan, ukuran sampel yang kecil, tidak adanya data casemix, tidak adanya data terkait harga, dan penelitian yang dilakukan pada satu waktu saja.
Sebanyak 35 studi (26%) menunjukkan kurangnya ketersediaan indikator kualitas, yang menyebabkan ketidakmampuan dalam menyesuaikan variabel output untuk kualitas. Tiga puluh empat penelitian (25%) menyatakan ukuran sampel kecil sebagai batasan (Gambar 7.2).
Gambar 7.2: Keterbatasan-keterbatasan yang disebutkan pada penelitian-penelitian yang terkumpul (Sumber: Hafidz, Ensor, dan Tubeuf (2018b))
Rata-rata, ukuran sampel fasilitas kesehatan yang dianalisis dalam studi ialah 101, dengan rata-rata 74 fasilitas untuk analisis yang dilakukan di rumah sakit dan 102 fasilitas dalam setting layanan primer. Jumlah rata-rata output adalah 3 (kisaran: 1 hingga 14); jumlah rata-rata input juga 3 (kisaran: 1 hingga 11). Dua puluh tiga studi (17%) menunjukkan bahwa data biaya dan harga sulit dikumpulkan. Tantangan ini mengarahkan para peneliti untuk menggunakan DEA, bukan SFA yang membutuhkan data keuangan. Kurangnya informasi campuran kasus untuk melakukan pembobotan keluaran juga dicatat sebagai keterbatasan dalam 24 studi (18%).
Temuan ini menjadi gambaran bagi para peneliti selanjutnya bahwa salah satu tantangan terbesar dalam melakukan pengukuran efisiensi fasilitas kesehatan adalah tidak lengkapnya data yang dibutuhkan. Oleh karena itu, sebelum melakukan studi pengukuran efisiensi, setiap peneliti hendaknya dapat memastikan ketersediaan data untuk melakukan analisis yang diinginkan; atau menyesuaikan pilihan teknik pengukuran sesuai dengan data yang bisa dikumpulkan. Selain itu, bagi pengambil kebijakan, temuan ini juga penting untuk memperbaiki ketersediaan sumber data administratif (kualitas layanan, pembiayaan, campuran kasus) untuk menyokong penelitian-penelitian yang lebih kuat di masa depan.
7.4 Izin Etik atau Ethical Clearance
Seperti yang dijelaskan pada bagian A, analisis efisiensi dapat dilakukan dengan data primer (peneliti melakukan pengumpulan data sendiri) atau data sekunder dari survei yang sudah dilakukan sebelumnya oleh pihak lain. Jika analisis efisiensi dilakukan menggunakan data sekunder, peneliti tidak memerlukan izin etik untuk melakukan penelitian efisiensi. Hal ini karena pihak yang mengumpulkan data (penyurvei seperti BPS atau Kementerian Kesehatan) sudah melakukan perizinan etik sebelum melakukan pengumpulan data.
Namun, peneliti harus memperhatikan aturan penggunaan dari masing-masing data, misalnya, apakah diperlukan izin tertulis dari penyurvei atau ketentuan yang lain. Pada saat publikasi, peneliti bisa menyebutkan bahwa data yang digunakan sudah melalui perizinan etik oleh pihak pengambil data. Informasi ini bisa didapat dari buku panduan penggunaan data yang biasanya disertakan pada setiap set data sekunder. Jika informasi tertulis tidak ada maka peneliti dapat berkorespondensi dengan pihak penyurvei untuk mendapatkan keterangan lebih lanjut.
7.5 Kesimpulan
Terdapat beberapa isu tambahan yang harus diperhatikan oleh peneliti ketika melakukan analisis efisiensi fasilitas kesehatan. Di antaranya, pemilihan sumber data, persiapan data sebelum analisis, penggunaan indeks casemix, kemungkinan keterbatasan penelitian, penyusunan variabel kontekstual, dan perizinan etik.
Analisis efisiensi dapat dilakukan menggunakan data primer maupun data sekunder. Beberapa sumber data sekunder di Indonesia yang bisa dimanfaatkan oleh peneliti, antara lain Riset Pembiayaan Fasilitas Kesehatan, Survei Sosioekonomi Nasional, Survei Potensi Desa, data INA-CBGs, dan data sampel BPJS Kesehatan.